Domain wollschal.de kaufen?
Wir ziehen mit dem Projekt
wollschal.de um.
Sind Sie am Kauf der Domain
wollschal.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain wollschal.de kaufen?
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **

Ähnliche Suchbegriffe für Informationsextraktion
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
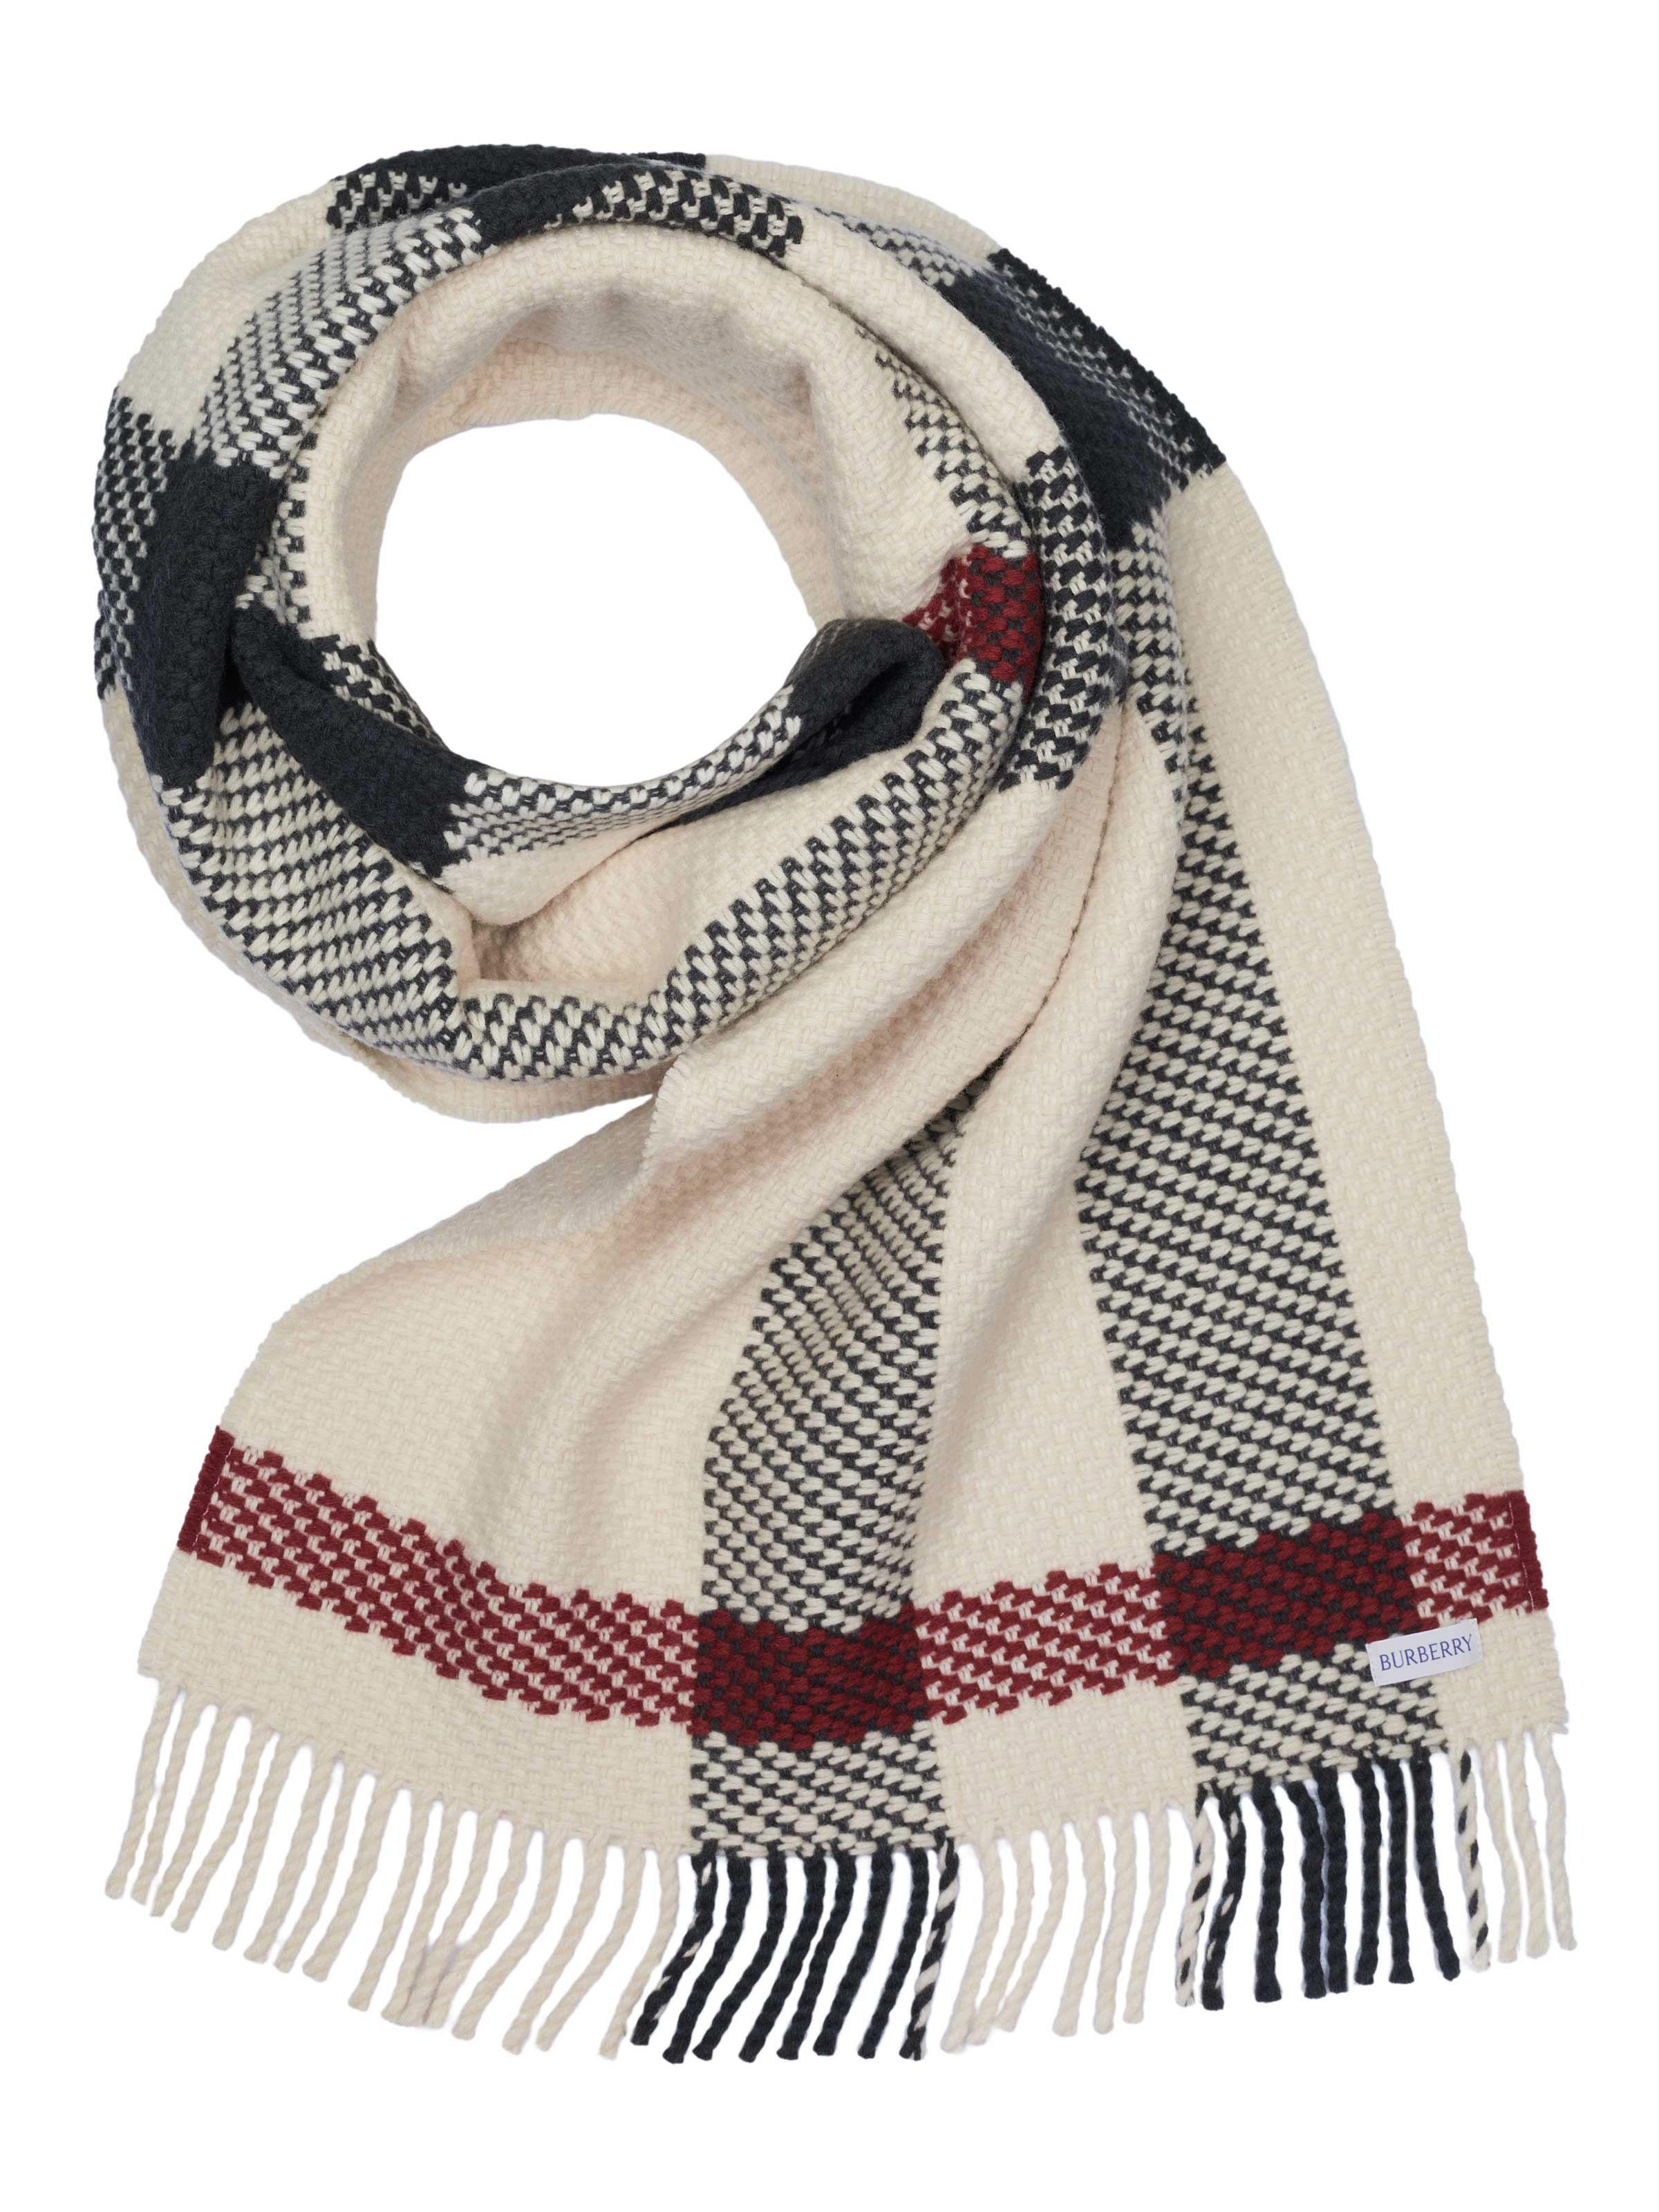
Küsten-Wollschal - 01Beherrscht die große Kunst des Weglassens. Sein Tweed-Mouliné-Garn aus 80 % reiner Wolle und 20 % Polyamid streut feine Farbpünktchen über die puristische Fläche des Schals. Im Half Cardigan Stitch gestrickt, liegt er voluminös am Hals und isoliert zuverlässig gegen Winterwind. Die 7-Gauge-Strickung gibt dem Schal Struktur, Weichheit und Formstabilität. Mit der passenden Küsten-Mütze wird daraus ein eingespieltes Team. "A perfect match", ganz ohne Kennenlernphase.59,95 €*Versand: 6,95 €Sichere Weiterleitung zum Anbieter
-
Buch "Strick-Lieblinge im Winter"Strick-Lieblinge im Winter. So klein, so süß und so schnell gestrickt! Ob als Glücksbringer, als kleines Mitbringsel für liebe Menschen, als Überraschung für den Adventskalender, als kleines Weihnachtsgeschenk oder als niedlicher Handschmeichler zum Kuscheln. Die 15 süßen Figuren begeistern als Winterkinder, Eisbär, Wichtel, Schneeman, Weihnachtsmann, Lebkuchenmännchen und noch so viel mehr. Freuen Sie sich auf großartigen Strickspaß für die kalte Jahreszeit, der Ihnen im Nu von der Hand und in Ihr Herz geht. Der enthaltene Grundkurs zeigt, wie es geht und lässt keine Fragen offen. Buch mit 48 Seiten. Größe: 17 x 22 cm.Verlag: frechverlag, Autorin: Brigitte Zimmermann11,00 €*Versand: 4,99 €Sichere Weiterleitung zum Anbieter
-
Wollschal "Strick-It", Damen, grau, Polyacryl, COLLEZIONE ALESSANDRO, unifarben, Basic, Modetücher, Strickschal, Made in ItalyDieser elegante Schal mit dem Modellnamen "Strick-It" ist ein absolutes Must-Have für die kalten Tage. Er wurde mit höchster Sorgfalt in Italien von der angesehenen Marke collezione alessandro gefertigt. Dieser Strickschal besticht durch seine...39,90 €*Versand: 5,95 €Sichere Weiterleitung zum Anbieter



-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **


Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
Tweed-Wollschal - 01Gelobt sei, was weich macht. In der Grafschaft Donegal, an der nordwestlichen Küste Irlands, weht ein anderer Wind und ab und zu regnet es nicht. Straffes Klima, um es mal wohlwollend zu beschreiben. Und, gezwungenermaßen, beste Voraussetzungen für die Herstellung besonders guttuender Wolle: dem berühmten Donegal-Tweed. Der übrigens erst dann perfekt und im besten Sinne natürlich ist, wenn kleine Schwankungen in der Lauflänge und Reißkraft auftreten.79,95 €*Versand: 6,95 €Sichere Weiterleitung zum Anbieter
-
Küsten-Wollschal - 01Beherrscht die große Kunst des Weglassens. Sein Tweed-Mouliné-Garn aus 80 % reiner Wolle und 20 % Polyamid streut feine Farbpünktchen über die puristische Fläche des Schals. Im Half Cardigan Stitch gestrickt, liegt er voluminös am Hals und isoliert zuverlässig gegen Winterwind. Die 7-Gauge-Strickung gibt dem Schal Struktur, Weichheit und Formstabilität. Mit der passenden Küsten-Mütze wird daraus ein eingespieltes Team. "A perfect match", ganz ohne Kennenlernphase.59,95 €*Versand: 6,95 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
Ähnliche Suchbegriffe für Informationsextraktion
-
Buch "Strick-Lieblinge im Winter"Strick-Lieblinge im Winter. So klein, so süß und so schnell gestrickt! Ob als Glücksbringer, als kleines Mitbringsel für liebe Menschen, als Überraschung für den Adventskalender, als kleines Weihnachtsgeschenk oder als niedlicher Handschmeichler zum Kuscheln. Die 15 süßen Figuren begeistern als Winterkinder, Eisbär, Wichtel, Schneeman, Weihnachtsmann, Lebkuchenmännchen und noch so viel mehr. Freuen Sie sich auf großartigen Strickspaß für die kalte Jahreszeit, der Ihnen im Nu von der Hand und in Ihr Herz geht. Der enthaltene Grundkurs zeigt, wie es geht und lässt keine Fragen offen. Buch mit 48 Seiten. Größe: 17 x 22 cm.Verlag: frechverlag, Autorin: Brigitte Zimmermann11,00 €*Versand: 4,99 €Sichere Weiterleitung zum Anbieter
-
Wollschal "Strick-It", Damen, grau, Polyacryl, COLLEZIONE ALESSANDRO, unifarben, Basic, Modetücher, Strickschal, Made in ItalyDieser elegante Schal mit dem Modellnamen "Strick-It" ist ein absolutes Must-Have für die kalten Tage. Er wurde mit höchster Sorgfalt in Italien von der angesehenen Marke collezione alessandro gefertigt. Dieser Strickschal besticht durch seine...39,90 €*Versand: 5,95 €Sichere Weiterleitung zum Anbieter
-
Strick, Heinz Klaus: Mathematik ist schönMathematik ist schön , Anregungen zum Anschauen und Erforschen für Menschen zwischen 9 und 99 Jahren , Stoßdämpferfedern > Radaufhängung, Federung & Lenkung , Auflage: 2., erweiterte und korr. Aufl. 2019, Erscheinungsjahr: 20190701, Produktform: Kartoniert, Beilage: Book, Autoren: Strick, Heinz Klaus, Auflage: 19002, Auflage/Ausgabe: 2., erweiterte und korr. Aufl. 2019, Seitenzahl/Blattzahl: 380, Abbildungen: 69 schwarz-weiße und 471 farbige Abbildungen, 510 farbige Tabellen, Bibliographie, Themenüberschrift: MATHEMATICS / General, Keyword: Elementarmathematik; Geometrie; Zahlentheorie; Fraktale; Kombinatorik; Unterhaltungsmathematik, Fachschema: Didaktik~Unterricht / Didaktik~Mathematik~Mathematik / Denken, Probleme, Unterhaltung, Fachkategorie: Fachspezifischer Unterricht~Mathematik~Die Natur: Sachbuch~Unterricht und Didaktik: Mathematik~Teaching of reading, writing and numeracy, Warengruppe: HC/Naturwissenschaften/Technik allg., Fachkategorie: Populäre Mathematik und Mathematik als Freizeitbeschäftigung, Thema: Verstehen, Text Sprache: ger, Seitenanzahl: XIII, Seitenanzahl: 377, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Springer-Verlag GmbH, Verlag: Springer-Verlag GmbH, Verlag: Springer Berlin, Länge: 234, Breite: 165, Höhe: 19, Gewicht: 746, Produktform: Kartoniert, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Vorgänger EAN: 9783662537299, eBook EAN: 9783662590607, Herkunftsland: NIEDERLANDE (NL), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0008, Tendenz: +1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel,37,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Liebmann, Irina: Wäre es schön? Es wäre schön!Wäre es schön? Es wäre schön! , 'Wäre es schön? Es wäre schön!' lautet die Überschrift eines von vielen Leitartikeln des glänzenden Journalisten Rudolf Herrnstadt. Bekannt wird der aus einer jüdischen Familie aus Oberschlesien stammende engagierte Kommunist, den es früh nach Berlin zieht, in der Weimarer Republik als Redakteur des Berliner Tageblatts. Langjährige Aufenthalte in Moskau, wo er auch eine Familie gründet, prägen ihn. Nach seiner Rückkehr steigt er auf zum Chefredakteur der Parteizeitung der DDR, bleibt aber eine streitbare Stimme. Aufgrund seiner Kritik am Umgang der Partei mit den Menschen wird er am Ende aus der SED ausgeschlossen. Aus Irina Liebmanns Gesprächen mit Zeitzeugen entsteht das Bild eines leidenschaftlichen und ironischen, humorvollen und radikalen Menschen, der bei den eigenen Genossen immer wieder aneckt. Mit der Vision einer Gesellschaft, in der die Einzelnen sich frei entfalten können, ist Herrnstadt tragisch gescheitert. Als großer Akteur der Zeitgeschichte bleibt er in diesem Buch lebendig. , Führungsschienen > Steuerketten, Zahnriemen & Einbausätze , Erscheinungsjahr: 20230622, Produktform: Leinen, Autoren: Liebmann, Irina, Seitenzahl/Blattzahl: 410, Keyword: Moskau; DDR; Zeitung; Berliner Tageblatt; Partei; Journalismus; Exil; Berlin; Weimarer Republik, Fachschema: DDR / Erinnerung, Gespräch, Tagebuch, Thema: Entdecken, Warengruppe: HC/Geschichte/Allgemeines/Lexika, Fachkategorie: Memoiren, Berichte/Erinnerungen, Thema: Auseinandersetzen, Text Sprache: ger, Originalsprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Schoeffling + Co., Verlag: Schoeffling + Co., Verlag: Schffling & Co. Verlagsbuchhandlung GmbH, Länge: 208, Breite: 133, Höhe: 32, Gewicht: 518, Produktform: Gebunden, Genre: Geisteswissenschaften/Kunst/Musik, Genre: Geisteswissenschaften/Kunst/Musik, Autor: 9783895612589 9783731761747, eBook EAN: 9783731762416, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0002, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 100058328,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
-
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.